[Python TIL] SET 자료형 집합 연산
Python의 set 자료형을 이용해서 쉽게 할 수 있는 집합 연산 (union, intersection, difference, symmetric difference) 을 예제와 함께 정리해보자.
이런 연산은 추천 알고리즘, 공통 관심사 분석, 유사도 측정 같은 곳에서 많이 쓰이기 때문에 꼭 알아두면 좋아!
🧠 Python set을 이용한 집합 연산 총정리
🔹 두 집합 정의부터 시작!
A = {1, 2, 3, 4}
B = {3, 4, 5, 6}
1️⃣ 합집합 (Union)
💡 의미: A 또는 B에 하나라도 포함된 원소들
✅ 방법
A | B           # 연산자
A.union(B)      # 메소드
🧪 예시 & 결과
print(A | B)         # 출력: {1, 2, 3, 4, 5, 6}
print(A.union(B))    # 출력: {1, 2, 3, 4, 5, 6}
2️⃣ 교집합 (Intersection)
💡 의미: A와 B에 모두 포함된 원소들
✅ 방법
A & B
A.intersection(B)
🧪 예시 & 결과
print(A & B)               # 출력: {3, 4}
print(A.intersection(B))   # 출력: {3, 4}
3️⃣ 차집합 (Difference)
💡 의미: A에는 있지만 B에는 없는 원소
✅ 방법
A - B
A.difference(B)
🧪 예시 & 결과
print(A - B)               # 출력: {1, 2}
print(A.difference(B))     # 출력: {1, 2}
4️⃣ 대칭차집합 (Symmetric Difference)
💡 의미: A 또는 B에는 있지만, 둘 다에 속하지 않은 원소
✅ 방법
A ^ B
A.symmetric_difference(B)
🧪 예시 & 결과
print(A ^ B)                       # 출력: {1, 2, 5, 6}
print(A.symmetric_difference(B))   # 출력: {1, 2, 5, 6}
📌 요약표
| 연산 | 설명 | 연산자 | 메소드 | 예시 결과 |
| 합집합 | A 또는 B | ` | ` | A.union(B) |
| 교집합 | A와 B 모두 | & | A.intersection(B) | {3, 4} |
| 차집합 | A에는 있고 B에는 없음 | - | A.difference(B) | {1, 2} |
| 대칭차집합 | A 또는 B에는 있지만 둘 다에는 없음 | ^ | A.symmetric_difference(B) | {1, 2, 5, 6} |
# 각 영화 별 시청자 리스트를 임포트합니다.
from viewers import dark_knight, iron_man

dark_knight_set = set(dark_knight)
iron_man_set = set(iron_man)

# 두 작품을 모두 시청한 사람의 수
both = len(dark_knight_set & iron_man_set)

# 두 작품 중 최소 하나를 시청한 사람의 수
either = len(dark_knight_set | iron_man_set)

# 다크나이트만 시청한 사람의 수
dark_knight_only = len(dark_knight_set - iron_man_set)

# 아이언맨만 시청한 사람의 수
iron_man_only = len(iron_man_set - dark_knight_set)


# 아래 주석을 해제하고 실행 결과를 확인해보세요.
print("두 작품 모두 시청: {}명".format(both))
print("하나 이상 시청: {}명".format(either))
print("다크나이트만 시청: {}명".format(dark_knight_only))
print("아이언맨만 시청: {}명".format(iron_man_only))
- 수를 셀 때는 len을 사용
🎯 활용 꿀팁
두 사람이 공통으로 본 영화 리스트 →
intersectionA가 본 영화 중 B는 안 본 영화 →
difference한 사람만 본 영화 →
symmetric_difference
실전 활용
이제 set을 이용한 실전 활용 중 하나인 자카드 유사도 (Jaccard Similarity) 에 대해 예시와 함께 봐보자.
자카드 유사도는 텍스트 분석, 추천 시스템, 클러스터링, 유사 문서 검색 등 다양한 분야에서 널리 쓰이는 기법이다.
📊 Jaccard Similarity란?
두 집합의 공통된 원소 비율을 통해 유사도를 계산하는 방법이다.
공식:
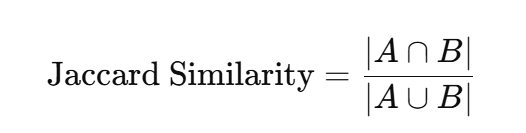
A: 첫 번째 집합
B: 두 번째 집합
∩: 교집합
∪: 합집합
📌 예시: 두 유저가 본 영화
user_A = {'Avengers', 'Frozen', 'Batman'}
user_B = {'Frozen', 'Avatar', 'Batman', 'Titanic'}
✅ 자카드 유사도 계산:
intersection = user_A & user_B  # {'Frozen', 'Batman'}
union = user_A | user_B         # {'Avengers', 'Frozen', 'Batman', 'Avatar', 'Titanic'}

jaccard_sim = len(intersection) / len(union)
print(f"자카드 유사도: {jaccard_sim:.2f}")
✅ 결과:
자카드 유사도: 0.40
교집합 개수: 2
합집합 개수: 5
유사도: 2 / 5 = 0.4
🧠 활용 아이디어
| 분야 | 활용 예 |
| 검색엔진 | 사용자가 입력한 키워드와 문서 키워드의 유사도 계산 |
| 추천 시스템 | 유저가 본 아이템과 다른 유저의 아이템 비교 |
| 문서 분류 | 뉴스 기사나 논문 간의 주제 유사도 측정 |
🎯 한 줄로 구현하기
jaccard_sim = len(user_A & user_B) / len(user_A | user_B)
🔥 실전 꿀팁
set자료형을 사용하면 자카드 유사도 계산이 매우 간단해진다.문장을 단어 집합으로 바꾸면 텍스트 유사도에도 활용 가능!
s1 = set("I love python".split())
s2 = set("I love AI and python".split())

print(f"자카드 유사도: {len(s1 & s2) / len(s1 | s2):.2f}")
# 출력: 자카드 유사도: 0.60